收藏了卻跑不動?6 萬星免費 AI 課 ai-engineering-from-scratch,455 支程式逐一實測
重點摘要
- ai-engineering-from-scratch 有 523 個課程資料夾,其中 455 課附 Python 程式;完全不裝任何套件時,367 支(80%)能直接跑完,全部跑完約 38 秒。
- 只多裝 numpy 後,390/455 支(85%)能跑;剩下的失敗大多是需要 PyTorch 的 52 課,官方 requirements.txt 列的 18 個套件多數課用不到。
- 「反向傳播」課完全不用套件,純 Python 約 14 秒把 80 個訓練點的圓內/圓外分類練到 100% 正確;「迷你 GPT 預訓練」課約 2 秒跑完但生成結果是亂碼,課程文件已說明輸出品質不是重點。
- 523 課講義全部只有英文,中文只有一份社群翻譯的簡體首頁 README。
- 結論: 八成課程不用安裝就能跑,適合想用純 Python 看懂 AI 原理的人,但講義全英文,想快速做出 AI 工具的人會覺得太繞。
- 適合: 看得懂英文、想理解神經網路與反向傳播等底層原理的自學者。
- 不適合: 只想直接用 AI 完成工作、或不想碰程式與英文的人。
| 實測項目 | 結果 |
|---|---|
| 課程資料夾/附 Python 程式 | 523/455 |
| 零安裝跑成功 | 367/455(80%),全部約 38 秒 |
| 只裝 numpy 跑成功 | 390/455(85%) |
| 裝 numpy 後仍失敗主因 | 需要 torch 52 課 |
| 官方 requirements.txt | 18 個套件 |
| 反向傳播課(純 Python) | 約 14 秒,80 個訓練點 100% 正確 |
| 迷你 GPT 預訓練課 | 約 1.7 秒,loss 5.57→5.06,輸出亂碼 |
| 講義語言 | 523 課只有英文 |
想自學 AI 的人,書籤裡大概都躺著幾套「從零開始」的課。常見的劇本是:打開第一課,看到要先裝 PyTorch、CUDA、Jupyter,光是環境就搞一個晚上,然後這套課就再也沒打開過。
這週 GitHub 上竄紅的 rohitg00/ai-engineering-from-scratch(一週多了約 5 千星,總數 6 萬多星)號稱 523 課、20 個階段、約 342 小時,「每一課都從零手刻」。我們沒有只看 README,而是把它所有附程式的課一支一支實際跑過,看看到底有多少課是「下載下來就能跑」。
測試設備:Mac mini M4 Pro(12 核、64GB),Python 3.12;受測版本為 2026-10-05 的 main 分支(commit 5b5ab48)。
怎麼測
課程放在 phases/ 底下,每一課是一個資料夾,有程式的課會附 code/main.py。先數一下規模:
git clone https://github.com/rohitg00/ai-engineering-from-scratch
cd ai-engineering-from-scratch
ls -d phases/*/*/ | wc -l          # 523 個課程資料夾
find phases -name main.py | wc -l  # 455 課附 Python 程式
接著寫一支小腳本,對 455 個 main.py 逐一執行:每支在自己的資料夾裡跑、上限 20 秒、不給任何輸入、4 支同時跑,最後統計結束碼為 0 的數量,並把失敗原因分類(缺哪個套件、超時、其他錯誤)。
要先說清楚判讀方式:這個測試只回答「能不能跑完」,沒有逐課核對輸出內容對不對。超過 20 秒的課多半是訓練迴圈比較久,不代表程式壞掉。
結果:不裝任何套件就有八成能跑
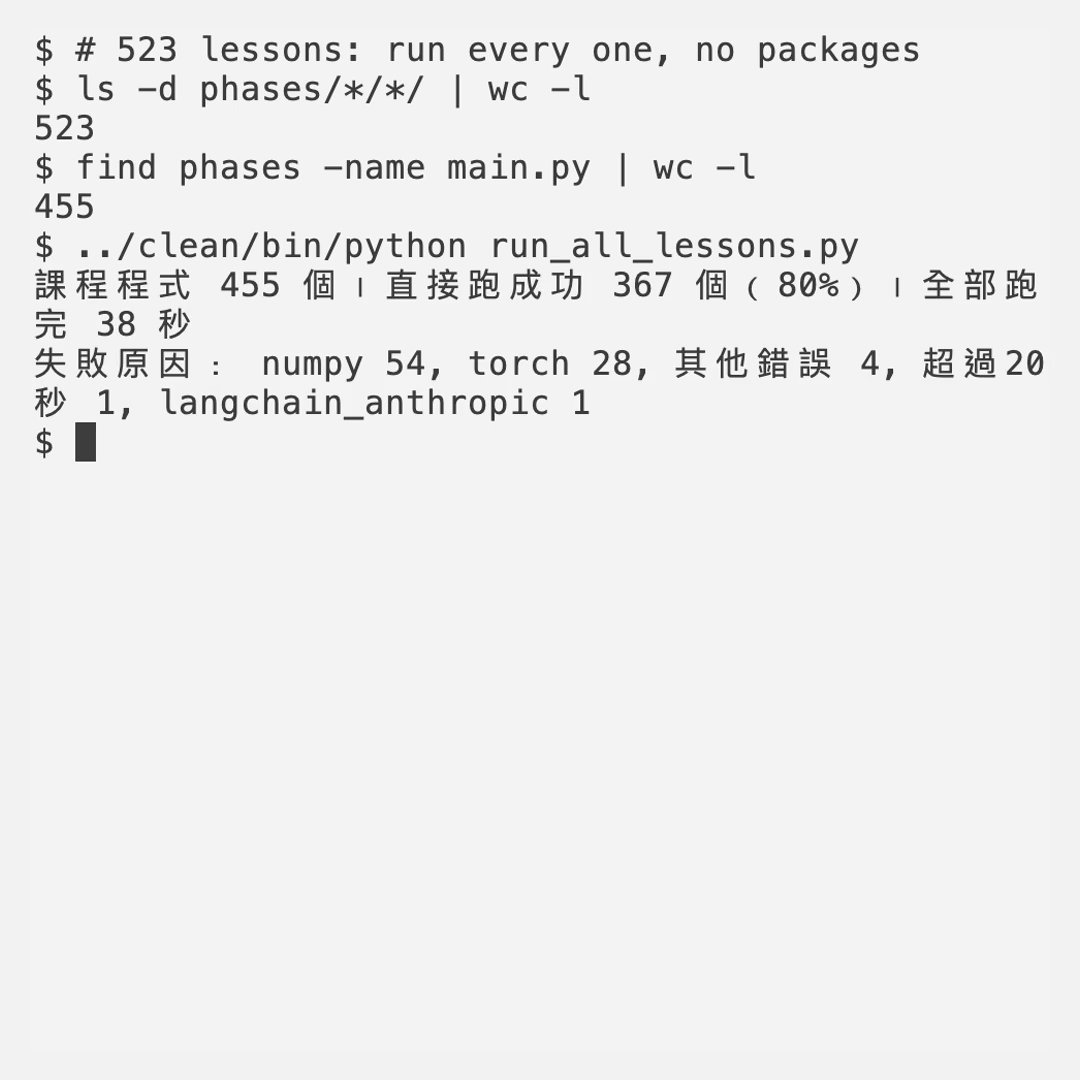
| 條件 | 跑成功 | 比例 | 全部跑完 |
|---|---|---|---|
| 什麼套件都不裝(只有 Python 標準函式庫) | 367 / 455 | 80% | 38 秒 |
| 只多裝 numpy | 390 / 455 | 85% | 約 70 秒 |
零安裝時失敗的 88 支,原因是:缺 numpy 54 支、缺 torch 28 支、其他錯誤 4 支、超時 1 支、缺 langchain_anthropic 1 支。
裝了 numpy 之後,剩下的失敗幾乎都是 PyTorch:52 課需要 torch(主要集中在電腦視覺等階段),另外 scipy、langchain_anthropic 各 1 課,還有兩課在執行時直接提示要先裝 zstandard、h5py。
換句話說,官方 requirements.txt 列了 18 個套件(torch、torchvision、transformers、anthropic、openai……),但前面大部分的課根本用不到。照官方一次裝完反而是最慢的開始方式;比較實際的做法是先什麼都不裝,跑到哪一課缺什麼再裝。
# 先不裝,直接跑一課看看
cd phases/03-deep-learning-core/03-backpropagation/code
python3 main.py

# 卡到 numpy 再裝
pip install numpy
最驚喜的一課:純 Python 手刻反向傳播
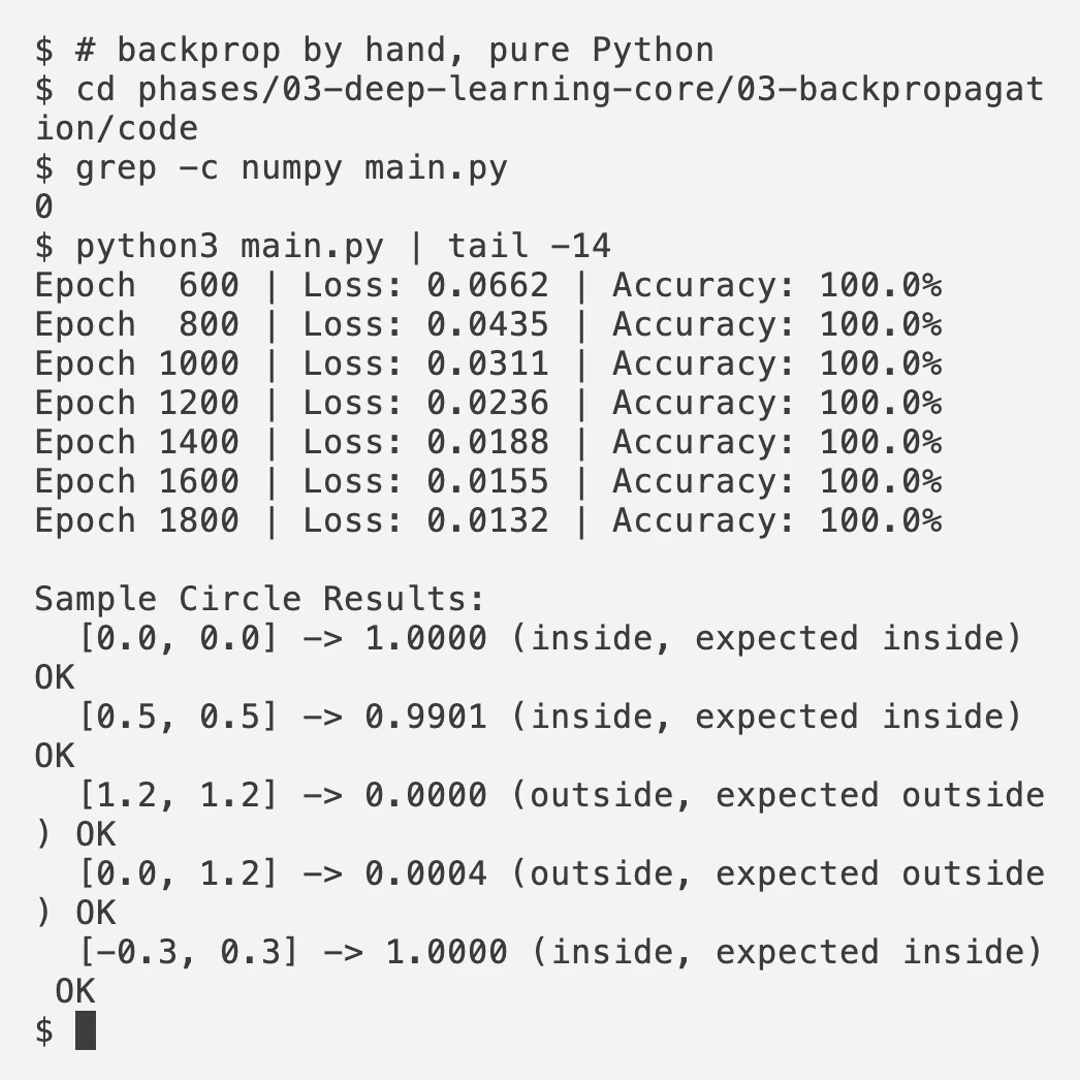
「反向傳播」這課(phases/03-deep-learning-core/03-backpropagation)整支程式只 import 了 math 和 random,grep -c numpy main.py 結果是 0。它自己實作了自動微分的 Value 物件、神經元、多層網路,先解 XOR,再訓練一個「點在圓內還是圓外」的分類器。
實測約 14 秒跑完:XOR 四組輸入全部答對;圓形分類在 80 個訓練點上,loss 從第 0 輪的 17.13 降到第 1800 輪的 0.0132,正確率 100%。要注意這個 100% 是在訓練資料上算的,不是另外的測試集。對想真正看懂「反向傳播到底在算什麼」的人,這種不藏在框架後面的寫法很有價值。
會讓人失望的一課:迷你 GPT 吐出亂碼
「從零預訓練迷你 GPT」這課(phases/10-llms-from-scratch/04-pre-training-mini-gpt)用 numpy 實作 4 層、4 頭、83 萬參數的小型 GPT,拿 876 個 byte 的英文段落訓練 200 步。單獨跑約 1.7 秒,loss 從 5.57 只降到 5.06,最後用「The transformer」接著生成,出來的是一串亂碼。
這不算 bug:課程文件自己就寫了,小資料、小模型的輸出「頂多半通順」,重點是能追蹤 embedding、注意力、softmax 到取樣的每一步。但如果你期待跑完會看到一個會講話的小模型,會落空。
另外一個小觀察:這課在 4 支同時跑的批次測試中超過了 20 秒,單獨跑卻不到 2 秒,推測是 numpy 多執行緒互相搶 CPU。批次測試裡「超時」的課,單獨重跑可能就沒事。
語言門檻
find phases -path '*/docs/*' -name en.md | wc -l   # 523
find phases -path '*/docs/*' -name 'zh*' | wc -l   # 0
523 課的講義全部只有英文。i18n/ 底下雖然有 12 種語言,包括中文,但都只是首頁 README 的社群翻譯,中文版是簡體。看不太懂英文的人,可以搭配翻譯工具讀,但要有心理準備。
結論
我會推薦給看得懂英文、想搞懂 AI 底層原理的人:八成的課不用裝任何東西就能跑,很多經典概念是純 Python 手刻,比直接呼叫框架更容易看懂。
但如果你的目標是趕快做出一個能用的 AI 工具,這套課太繞了;後段的大型模型課也大多需要 PyTorch,前面的「零安裝」優勢會消失。
- 適合:想理解神經網路、注意力、反向傳播原理,願意讀英文講義的人。
- 不適合:只想直接用 AI 完成工作、或完全不想碰程式和英文的人。
專案連結:https://github.com/rohitg00/ai-engineering-from-scratch(MIT 授權)