掃描公告搜不到字?OCRmyPDF 找回九個關鍵詞,日期卻要再檢查
重點摘要
- 同一頁自製 200 dpi 繁中公告,原檔擷取為 0 個非空白字元;OCRmyPDF 17.13.0 指定 chi_tra 後,單次 1.271 秒擷取 176 個非空白字元,9 個指定關鍵詞全數出現。
- 對這張公告使用預設英文辨識,單次 0.966 秒輸出 206 個非空白字元,但 9 個指定中文關鍵詞皆未出現;字數不是正確率。
- 繁中辨識保留 2,850、3,150、120 三筆測試金額,但 pdftotext 將日期拆成先出現「年10月25 日」、後出現「繳費期限 :2026」,閱讀順序與原稿不同。
- 同一公告整頁旋轉 90 度後,只做 deskew 的指定詞命中為 0/9;增加 rotate-pages 並將門檻設為 1,單次 1.742 秒命中 9/9。
- 結論: 本次自製公告可從無文字變成能搜尋九個指定詞,但擷取日期的順序仍需對照原圖。
- 適合: 想讓類似本次印刷繁中公告的掃描 PDF 可搜尋,且願意核對擷取結果的人;本次九個指定詞皆找回。
- 不適合: 要把 OCR 文字直接當成可靠日期欄位的流程;本次 pdftotext 擷取日期已有順序錯誤。
| 實測項目 | 結果 |
|---|---|
| 實測項目 | 結果 |
| 原始影像 PDF | 0 個非空白字元 |
| 200 dpi 預設英文 | 0.966 秒;206 字元;0/9 詞 |
| 200 dpi chi_tra | 1.271 秒;176 字元;9/9 詞;3/3 金額 |
| 200 dpi chi_tra+eng | 1.454 秒;176 字元;9/9 詞 |
| 90 度只做 deskew | 1.672 秒;193 字元;0/9 詞 |
| 90 度轉正門檻 1 | 1.742 秒;176 字元;9/9 詞 |
| 100 dpi chi_tra+eng | 1.109 秒;176 字元;9/9 詞 |
收到一張掃描公告,明明看得見「管理費」,搜尋卻沒有結果;想把繳費期限貼進行事曆,也選不到文字。這次我們用自己製作的社區公告,測試 OCRmyPDF 能不能替這種純圖片 PDF 加上可搜尋的文字。公告、金額與社區名稱都是測試資料,不是真實帳單。
測試設備為 Mac mini M4 Pro(12 核、64GB)。受測版本是 OCRmyPDF 17.13.0,原始碼 commit 為 58048da,搭配 Tesseract 5.3.0 與繁中語言包。樣本是一頁 200 dpi 公告,加入 1.2 度傾斜及少量雜點,另製作整頁旋轉九十度與 100 dpi 版本。下列時間是單次處理耗時,不包含安裝;不是大量文件的效能保證。錄影另跑一次,繁中為 1.333 秒、轉正為 1.855 秒,因此截圖與表格的耗時略有差異。
先選對辨識語言
原檔用 pdftotext 擷取,排除空白後是零個字元。直接使用預設英文辨識,雖然產出 206 個字元,卻多是怪英文。事先選好的九個中文關鍵詞,一個也沒找到。改用繁中 -l chi_tra,1.271 秒得到 176 個非空白字元,九個詞全部出現。
ocrmypdf -l chi_tra --deskew \
  --sidecar demo/traditional.txt \
  demo/scan.pdf demo/out_traditional.pdf
pdftotext demo/out_traditional.pdf -
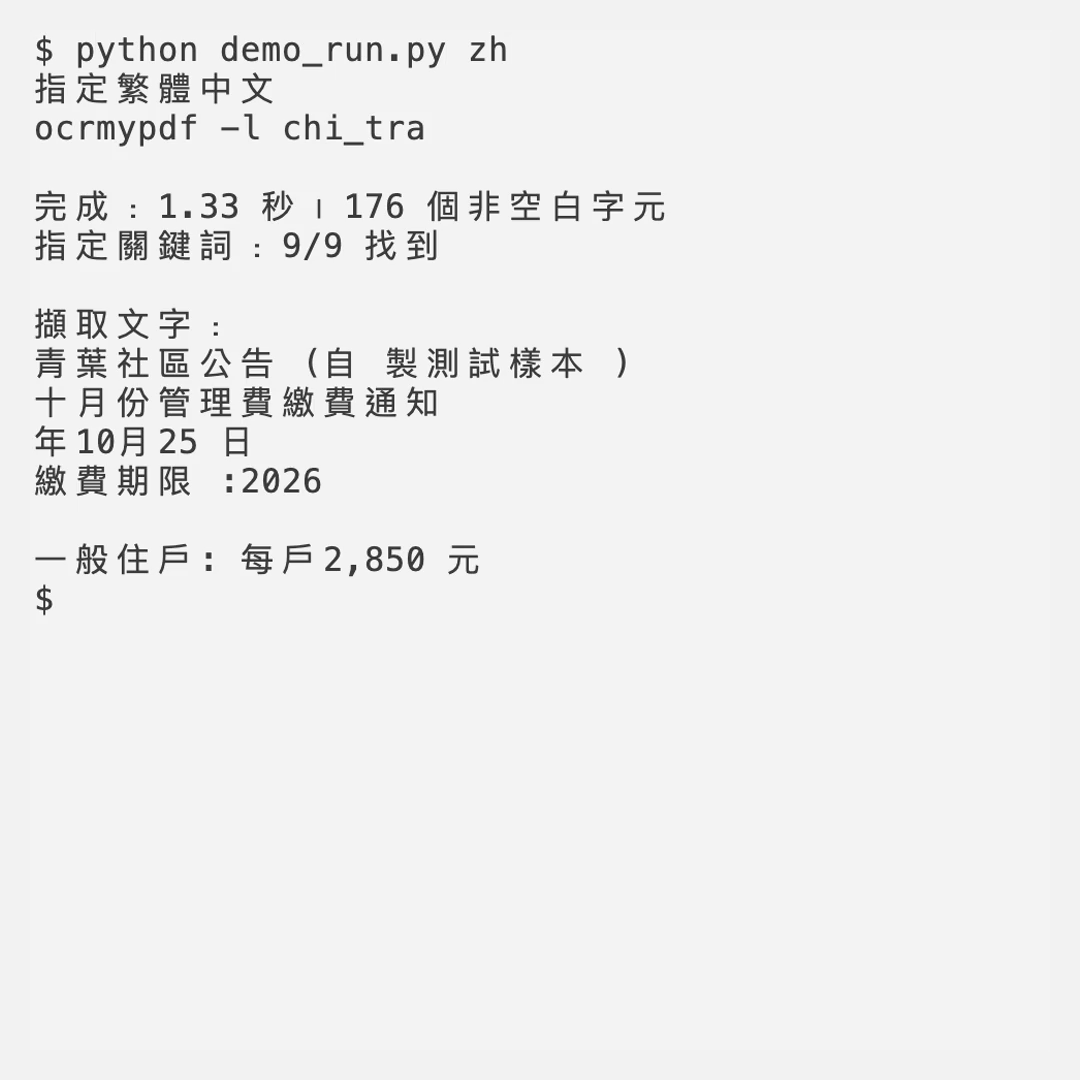
九個詞是青葉社區、管理費、繳費期限、管理室、轉帳、收據、公共照明、側門、管理委員會。比對前只移除空白,檢查詞是否出現在擷取結果;這不是逐字辨識準確率。原稿也有 176 個非空白字元,但字數相同不代表文字、標點與順序完全一致。
畫面正確,複製順序仍可能有問題
三筆測試金額 2,850、3,150、120 都保留正確。不過原稿的「繳費期限:2026年10月25日」,擷取後變成先出現「年10月25 日」,下一行才是「繳費期限 :2026」。我們重新開啟產出 PDF,頁面看起來正常;問題出在文字讀取順序。
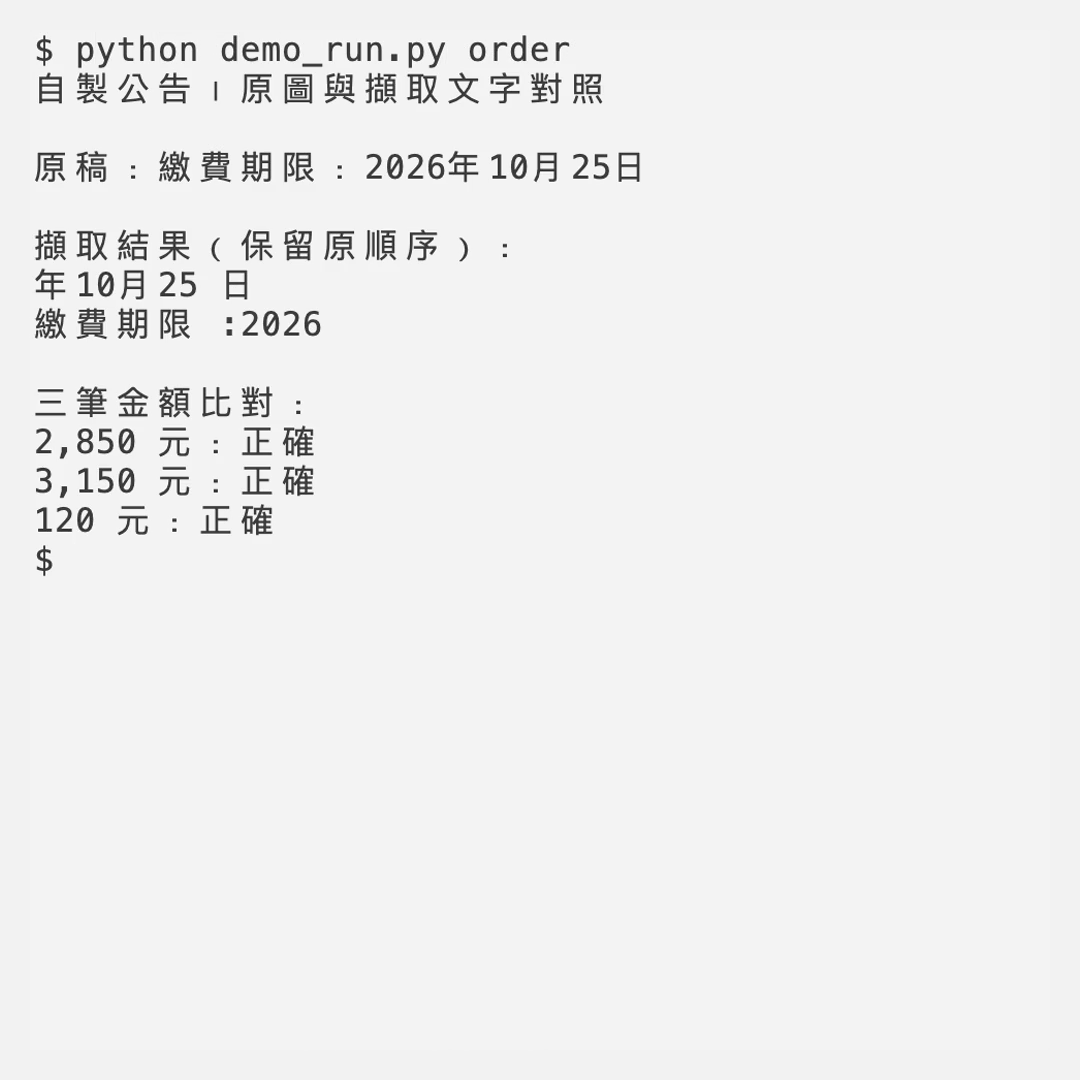
這是我會保留原圖的原因:找一份提到管理費的公告很方便,但把整段文字直接交給其他程式整理日期,仍可能帶入錯誤。這次沒有測試各種閱讀器的複製行為,不能把 pdftotext 的結果推論成所有軟體都一樣。
歪斜與整頁轉向,是兩件事
把公告整頁轉九十度,只加 --deskew,得到 193 個非空白字元,九個關鍵詞再次全部消失。加上轉正選項,並把判斷門檻設為 1 後,1.742 秒找回九個詞。
ocrmypdf -l chi_tra+eng --deskew \
  --rotate-pages --rotate-pages-threshold 1 \
  demo/sideways.pdf demo/out_rotated.pdf
| 實測設定 | 耗時 | 非空白字元 | 指定詞命中 |
|---|---|---|---|
| 預設英文 | 0.966 秒 | 206 | 0/9 |
| 繁體中文 | 1.271 秒 | 176 | 9/9 |
| 繁中加英文 | 1.454 秒 | 176 | 9/9 |
| 九十度、只做歪斜校正 | 1.672 秒 | 193 | 0/9 |
| 九十度、轉正門檻設為 1 | 1.742 秒 | 176 | 9/9 |
| 100 dpi、繁中加英文 | 1.109 秒 | 176 | 9/9 |
降低轉正門檻只驗證了這個樣本,不能當成所有文件的通用最佳設定。100 dpi 樣本也找回九個詞,卻有更多斷行。測試過程曾因我們的腳本把輸入與輸出取成同名,污染一次後續測試;該輪作廢,重建原始樣本、改用不同檔名重測,表格只採修正後結果。
我會把它用在「讓舊掃描檔可以搜尋」:這張公告確實從零文字變得能找關鍵詞。需要直接取用完整日期、金額或固定欄位的人,仍要加入原圖核對;這一頁公告不足以證明其他字型、手寫字或複雜表格也可靠。