社群配圖每次重做?ComfyUI 留下生圖流程,重現成功也要檢查杯子
重點摘要
- ComfyUI搭配SD-Turbo完成三次512×512文字生圖,編號順序為42、43、42。
- 本次第一張輸出耗時14.09秒,另兩次各13.05秒,時間含API輪詢等待。
- 第一張與第三張RGB像素SHA-256相同;此結論只適用本次相同條件。
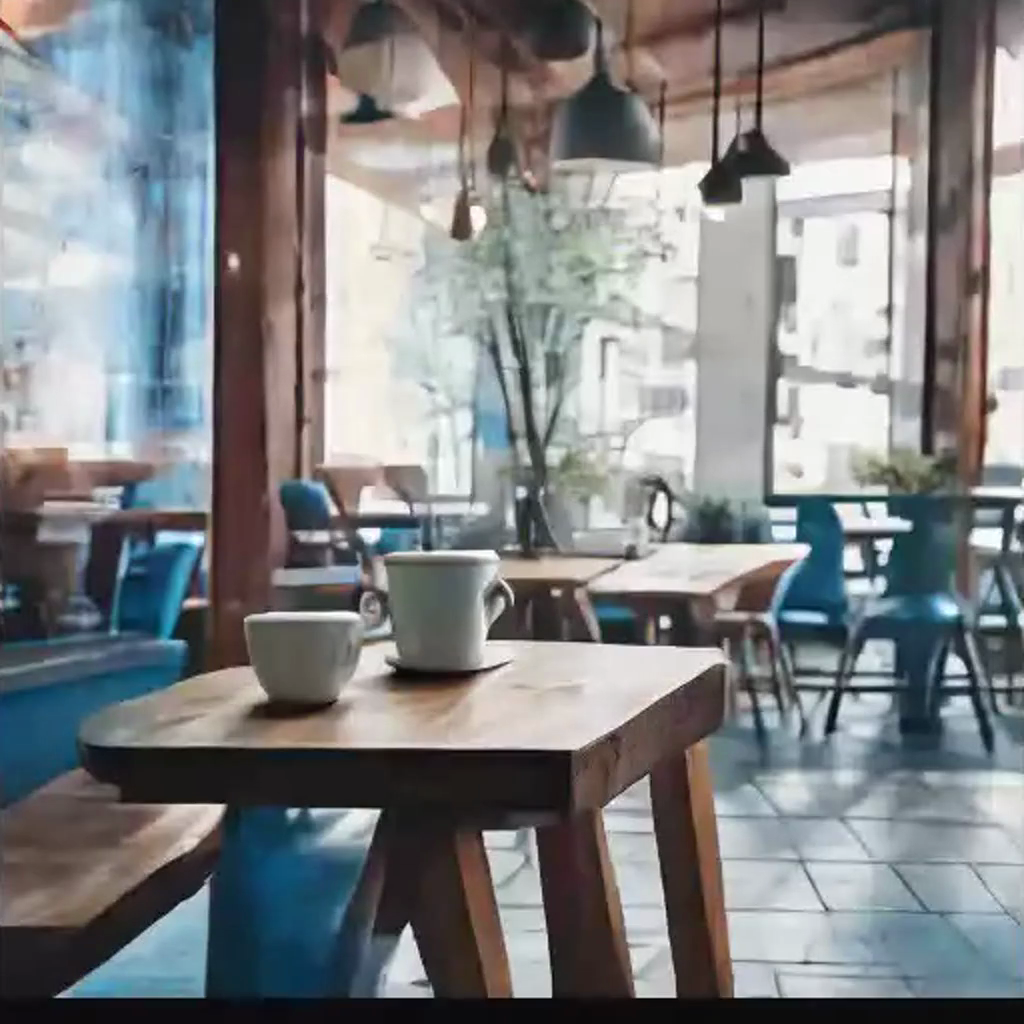
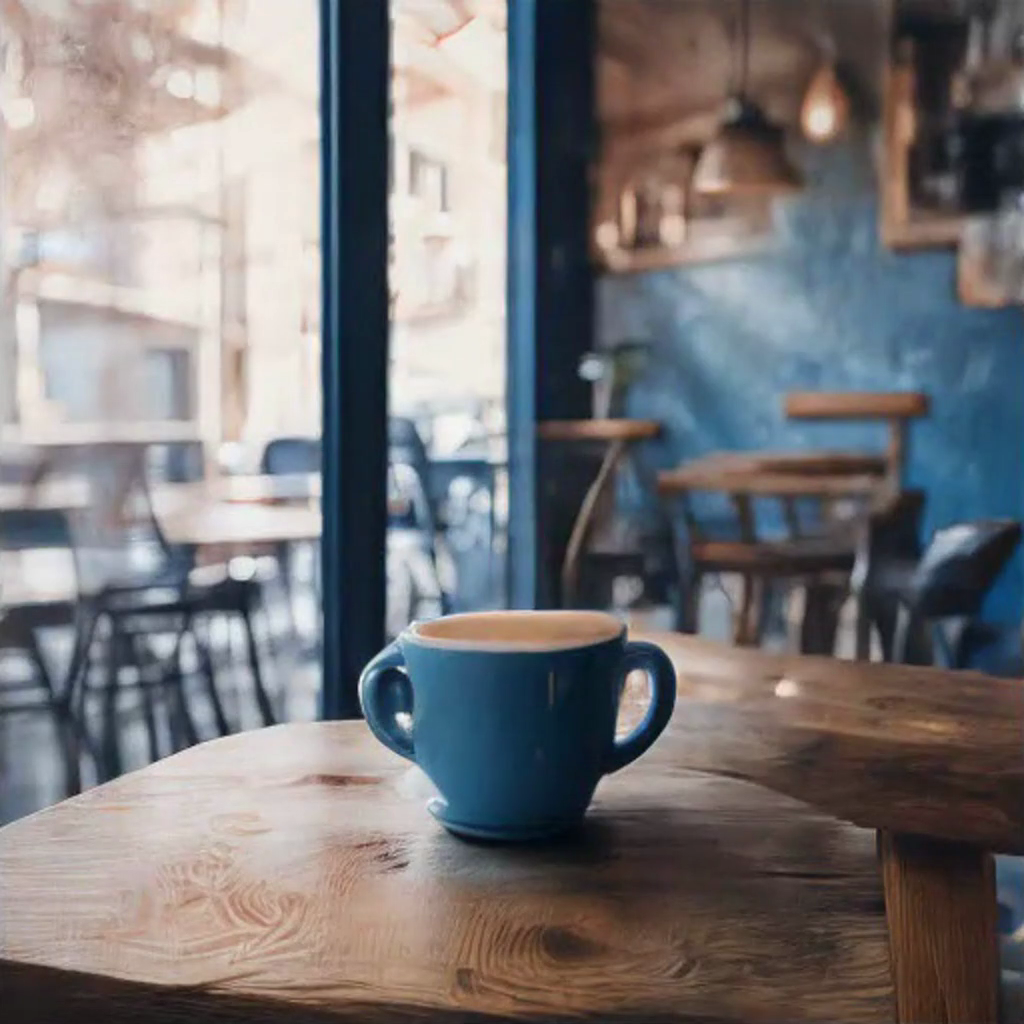
- 人工檢視第一張未遵循藍杯要求,第二張藍杯有兩個把手,輸出仍需檢查。
- 結論: 本次能保留流程並重現相同像素,指定杯色與杯子形狀仍有瑕疵。
- 適合: 願意保存流程、調整設定並人工檢查配圖的人
- 不適合: 期待這次設定直接產生無瑕疵成品的人
| 實測項目 | 結果 |
|---|---|
| 輸出尺寸 | 三次皆512×512 |
| API取得輸出耗時 | 14.09 / 13.05 / 13.05秒 |
| 同編號重現 | 42→43→42,首尾像素相同 |
| 實際瑕疵 | 白杯與雙把手藍杯 |
| 模型下載量 | 2,580,060,470 bytes |
替咖啡店排社群貼文,今天生出一張喜歡的配圖,下次想沿用,卻忘了當時的模型、文字和設定。ComfyUI 的用途,是把這些步驟接成可以保留、修改和重跑的流程。這次真的接上 SD-Turbo 生圖,看看「留住做法」能做到哪裡。畫面是 AI 生成的咖啡店示意配圖,不是真實店家的照片。
本次測試條件
日期為 2026 年 10 月 28 日。設備是 Mac mini M4 Pro,12 核、64GB;本次可運算資源限制為 3 核心、6GB RAM,使用 CPU 推論,沒有用主機 GPU。ComfyUI 版本 0.43.0,提交 426f5eea52a7ece1dd599fff4cb6cd1f352ddd24,Python 3.12.14、PyTorch 2.14.1+cpu,模型為 Stability AI 官方 SD-Turbo。數字是這一組條件的結果,不是所有電腦的速度。
下載與準備
以下是本次跑成功的 Linux/CPU 路徑。先準備 Python 3.12、Git 及足夠磁碟空間,再下載專案與套件。原生桌面版的安裝方式請依官方文件,本文不把這次結果當成其他系統的保證。
git clone https://github.com/Comfy-Org/ComfyUI.git
cd ComfyUI
git checkout 426f5eea52a7ece1dd599fff4cb6cd1f352ddd24
python3 -m venv .venv
. .venv/bin/activate
python3 -m pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cpu
python3 -m pip install -r requirements.txt
mkdir -p models/diffusion_models models/text_encoders models/vae
curl -fL https://huggingface.co/stabilityai/sd-turbo/resolve/main/unet/diffusion_pytorch_model.fp16.safetensors -o models/diffusion_models/sd_turbo_unet.safetensors
curl -fL https://huggingface.co/stabilityai/sd-turbo/resolve/main/text_encoder/model.fp16.safetensors -o models/text_encoders/sd_turbo_clip.safetensors
curl -fL https://huggingface.co/stabilityai/sd-turbo/resolve/main/vae/diffusion_pytorch_model.fp16.safetensors -o models/vae/sd_turbo_vae.safetensors
OMP_NUM_THREADS=3 OPENBLAS_NUM_THREADS=3 python3 main.py --cpu --force-fp16 --listen 127.0.0.1 --port 8188 --disable-all-custom-nodes --disable-api-nodes --cache-none
三個模型檔合計 2,580,060,470 位元組,約 2.58GB,還不含套件。這次不需要付費 API 金鑰。--cache-none 關閉節點中間結果快取,讓後面的重現比較確實再執行一次;本機網頁位址是 http://127.0.0.1:8188。
把完整做法留下來
這次用內建 API 提交九個節點,沒有另外安裝自訂節點。流程依序是讀入模型、把文字轉成條件、建立空白畫布、取樣生圖、解碼及存檔。「變化編號」就是程式中的 seed。把下面內容存成 coffee_demo.py,另開終端機、進入相同專案並啟用虛擬環境,執行 python3 coffee_demo.py。程式會保留完整流程與輸出收據,適合接到重複製作的工作裡。
import hashlib, json, pathlib, time, urllib.request
from PIL import Image

def api(path, data=None):
    req = urllib.request.Request('http://127.0.0.1:8188' + path,
        data=json.dumps(data).encode() if data else None,
        headers={'Content-Type': 'application/json'})
    return json.load(urllib.request.urlopen(req, timeout=60))

def node(kind, **inputs):
    return {'class_type': kind, 'inputs': inputs}

text = ('A cozy small coffee shop interior, wooden table, '
        'a blue ceramic coffee cup, warm morning sunlight, '
        'photography, no people, no text')
graph = {
    '1': node('UNETLoader', unet_name='sd_turbo_unet.safetensors', weight_dtype='default'),
    '2': node('CLIPLoader', clip_name='sd_turbo_clip.safetensors', type='stable_diffusion', device='cpu'),
    '3': node('VAELoader', vae_name='sd_turbo_vae.safetensors'),
    '4': node('CLIPTextEncode', text=text, clip=['2', 0]),
    '5': node('CLIPTextEncode', text='', clip=['2', 0]),
    '6': node('EmptyLatentImage', width=512, height=512, batch_size=1),
    '7': node('KSampler', model=['1', 0], positive=['4', 0], negative=['5', 0],
              latent_image=['6', 0], seed=42, steps=1, cfg=1.0,
              sampler_name='euler_ancestral', scheduler='normal', denoise=1.0),
    '8': node('VAEDecode', samples=['7', 0], vae=['3', 0]),
    '9': node('SaveImage', images=['8', 0], filename_prefix='coffee42')
}
pathlib.Path('coffee_workflow_api.json').write_text(json.dumps(graph, indent=2))
results = []
for seed in [42, 43, 42]:
    graph['7']['inputs']['seed'] = seed
    graph['9']['inputs']['filename_prefix'] = 'coffee' + str(seed)
    started = time.monotonic()
    pid = api('/prompt', {'prompt': graph})['prompt_id']
    for attempt in range(500):
        time.sleep(1)
        hist = api('/history/' + pid)
        if pid not in hist:
            continue
        row = hist[pid]
        if row.get('status', {}).get('status_str') == 'error':
            raise RuntimeError(row['status'])
        info = row['outputs']['9']['images'][0]
        image = pathlib.Path('output') / info['subfolder'] / info['filename']
        pixels = Image.open(image).convert('RGB')
        result = {'seed': seed, 'seconds': round(time.monotonic()-started, 2),
                  'filename': str(image), 'size': pixels.size,
                  'pixel_sha256': hashlib.sha256(pixels.tobytes()).hexdigest()}
        results.append(result)
        print(result)
        break
    else:
        raise TimeoutError('請查 ComfyUI 終端機日誌')
pathlib.Path('coffee_results.json').write_text(json.dumps(results, indent=2))
print('同設定像素相同:', results[0]['pixel_sha256'] == results[2]['pixel_sha256'])
實際跑出什麼
| 次序 | 變化編號 | 取得輸出耗時 | 結果 |
|---|---|---|---|
| 第一次 | 42 | 14.09 秒 | 512×512;出現白杯,沒有遵循藍杯要求 |
| 第二次 | 43 | 13.05 秒 | 512×512;藍杯左右各有一個把手 |
| 第三次 | 42 | 13.05 秒 | 512×512;與第一張逐像素相同 |
時間從提交工作到輪詢取得輸出,包含約一秒粒度的輪詢等待,不等於純模型推論時間。三次都使用相同文字與模型,只換編號。第一張和第三張 RGB 像素 SHA-256 都是 57589863ff8825165c6235c2ebc38ebfae7391882dc78f95834a578e311aa9d0;這支持本次相同條件能重現,不保證換硬體、套件或模型後仍完全相同。
判讀與常見問題
保留流程不代表每張圖都符合文字。杯子顏色不對、把手變兩個,都是這次真實輸出的問題,不該用重現成功掩蓋。若工具回報找不到模型,先對照三個資料夾與檔名;若 API 拒絕工作,查看 node_errors 和啟動視窗,不要把沒有存圖當成成功。這次三次生圖皆完成,沒有遇到上述兩類錯誤。
我的結論是:反覆做配圖、願意自己調整並檢查成品的人,可以利用它保留做法;想不調設定就拿到完美圖片的人,這次結果還不符合期待。這不是圖片編輯、影片或進階節點的全面測評,那些功能本次沒有驗證。配圖也不能冒充店家真實空間。
專案:ComfyUI,程式碼 GNU GPL v3;模型:SD-Turbo 模型卡 與模型授權。程式碼與模型的條款分開看,商業用途依模型發布者的現行條款確認。