AI 腔和真人文字都拿 83 分?實測 2.8 萬星 Claude Code 技能包 claude-skills
重點摘要
- claude-skills 實際有 846 個 SKILL.md,其中 458 個是 .gemini 資料夾的複本;扣掉後 388 個,與 README 開頭一致,依名稱去重為 374 個。
- 附帶的 745 支 Python 小程式逐支執行 --help,12 秒跑完,699 支正常、46 支失敗,其中 23 支來自 skillopt-sleep 套件的 types.py 撞名。
- 去 AI 味評分 humanizer_scorer 對英文有效(AI 腔 47 分、真人 79 分),但中文 AI 腔與中文真人文字都拿 83 分,分不出來。
- 文案標題評分 headline_scorer 用空格數字數:中文標題「Sherlock 工具介紹」20 分,低於只打「123」的 38 分。
- 結論: 說明書數量大致誠實、附帶程式九成以上能啟動,但評分工具只懂英文,中文內容別信它的分數。
- 適合: 用英文寫行銷內容、或想找現成流程範本的軟體團隊,挑需要的技能裝。
- 不適合: 想檢查中文文案或中文標題的人,以及想整包全裝的人。
| 實測項目 | 結果 |
|---|---|
| README/簡介宣稱技能數 | 388、345、380 |
| SKILL.md 總數/.gemini 複本 | 846/458 |
| 扣掉複本/名稱去重 | 388/374 |
| 小程式 --help 測試 | 745 支,699 正常、46 失敗,12.2 秒 |
| humanizer_scorer 英文 AI 腔/真人 | 47/79 |
| humanizer_scorer 中文 AI 腔/真人 | 83/83 |
| headline_scorer「Sherlock 工具介紹」/「123」 | 20/38 |
你想叫 AI 幫忙寫粉專貼文、廣告文案,網路上剛好有人在傳:「裝這一包,Claude Code 一次多三百多個專家技能,行銷、財務、法遵、執行長顧問全包。」這個叫 claude-skills 的專案在 GitHub 上有 2.8 萬顆星,最近一週就多了九百多顆。
聽起來很省事,但「三百多個專家」到底是什麼?裝了真的有用嗎?我們把它整包抓下來,數了一遍,再挑幾個一般人用得到的附帶工具實際跑跑看。
測試設備:Mac mini M4 Pro(12 核、64GB),Python 3.12,專案版本為 2026-08-26 的 commit 19392f7。
先搞清楚:「技能」是什麼
Claude Code 的「技能(skill)」本質上是一份 SKILL.md 說明書,告訴 AI 遇到某類工作時該照什麼步驟做,有些技能另外附了 Python 小程式當輔助。所以這個專案的主體是一大堆說明書,真正會「跑」的是那些附帶小程式。
這次我們沒有把技能裝進 Claude Code 讓 AI 實際使用,只測了兩件事:數量是否和宣稱一致、附帶的小程式能不能用。這點先講清楚。
宣稱幾個?實際幾個?
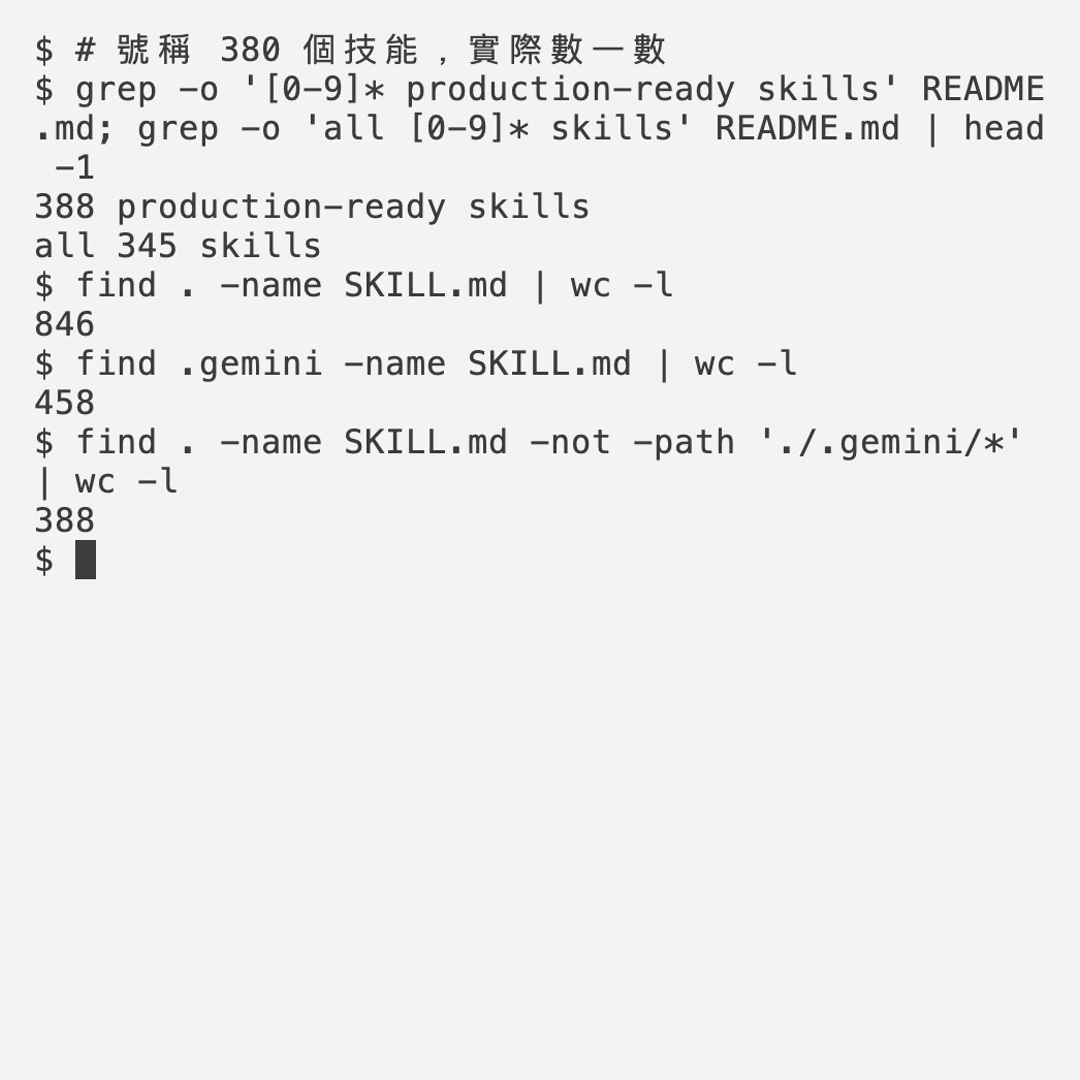
同一個專案裡出現了三個數字:README 開頭寫 388 個,另一段寫「All 345 skills」,GitHub 簡介又寫 380 個。我們直接數檔案:
grep -o '[0-9]* production-ready skills' README.md
grep -o 'all [0-9]* skills' README.md | head -1
find . -name SKILL.md | wc -l
find .gemini -name SKILL.md | wc -l
find . -name SKILL.md -not -path './.gemini/*' | wc -l
| 項目 | 數量 |
|---|---|
| SKILL.md 總數 | 846 |
放在 .gemini 資料夾的複本 |
458 |
| 扣掉複本 | 388 |
依 name: 欄位去重後 |
374 |
扣掉給 Gemini CLI 用的複本,剛好是 388 個,和 README 開頭一致,這點值得肯定。不過其中有 14 個名字重複(例如 chaos-engineering、slo-architect 在兩個資料夾各有一份),真正不重複的技能是 374 個。另外 .gemini 那份裡有 61 個名字在主目錄找不到,看起來是沒同步的舊版。
技能分布也很能說明它是給誰用的:工程類(engineering 93 個、engineering-team 53 個)最多,其次是行銷 49 個、執行長顧問 46 個。一般人日常會用到的生產力類只有 12 個。
745 支小程式,逐支試跑
附帶的 Python 小程式(不算 .gemini 複本)有 745 支。我們沒有安裝任何額外套件,逐支執行 python3 腳本 --help,每支限時 15 秒:
python3 /tmp/helpcheck.py
# scripts 745 ok 699 bad 46 sec 12.2
12 秒跑完,699 支正常顯示說明(約 94%),46 支失敗。失敗原因分類:
- 23 支來自同一個
skillopt-sleep套件:套件裡有個自己的types.py,單獨執行時蓋掉 Python 內建的types模組,造成循環匯入。這些檔案原本是套件模組,不是設計來單獨執行的,所以這個數字對作者不完全公平。 - 14 支找不到
book_to_skill、skillopt_sleep套件,要先安裝對應套件。 - 5 支找不到需要的檔案或指令(例如
dist/main.js、content/titles.md、pytest)。 - 其餘 4 支是其他原因,例如找不到
src/module.py、npm 找不到package.json。
要注意:「能顯示說明」只代表程式能啟動,不代表功能正確。所以接下來挑兩個實際跑。
去 AI 味評分:英文分得出來,中文分不出來
content-humanizer 技能附了一支 humanizer_scorer.py,宣稱能替文章打 0–100 的「人味分數」。我們自己寫了四段內容相同、口吻不同的文字:英文 AI 腔、英文真人口吻、中文 AI 腔(「在當今快速變化的數位時代,善用數據洞察至關重要。此外……總而言之……」)、中文真人口吻(「上個月我們的客人一直跑掉,我原本以為是價錢太貴」)。
S=marketing-skill/skills/content-humanizer/scripts/humanizer_scorer.py
python3 $S en_ai.txt | grep -E 'SCORE|Verdict'
python3 $S zh_ai.txt | grep -E 'SCORE|Verdict'
| 測試文字 | 人味分數 | 判定 |
|---|---|---|
| 英文 AI 腔 | 47 | Robotic |
| 英文真人口吻 | 79 | Mostly human |
| 中文 AI 腔 | 83 | Mostly human |
| 中文真人口吻 | 83 | Mostly human |
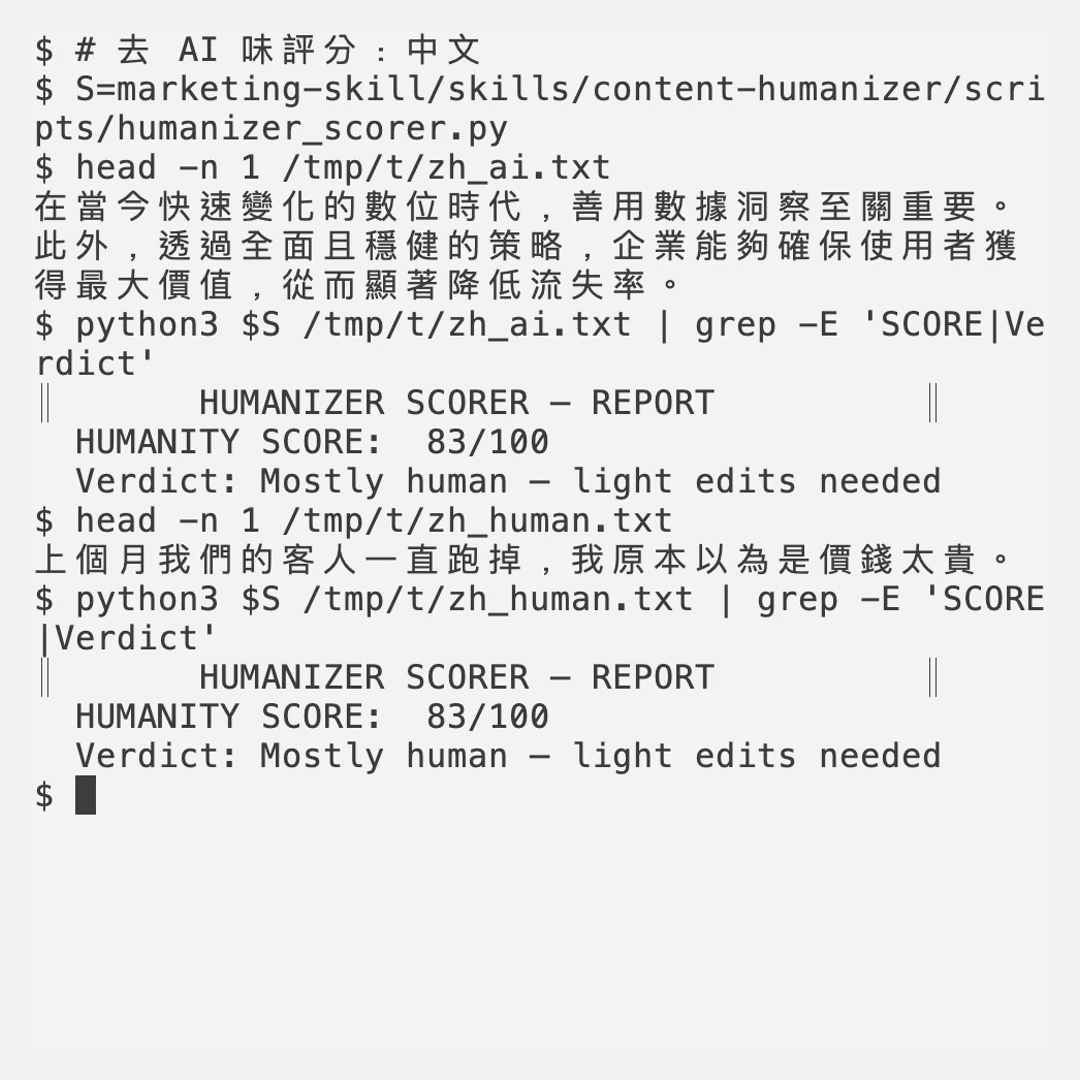
英文兩段差了 32 分,確實分得出來。中文兩段卻同分,而且 AI 腔的中文還比英文真人文字高分。原因翻程式碼就看得到:它的「AI 詞彙」清單全是英文(delve、leverage、robust、furthermore……)。中文 AI 腔那段在「AI 詞彙」「避險語氣」兩項都拿滿分,等於最能抓 AI 腔的兩項對中文完全沒作用。
標題評分:中文標題輸給「123」
copywriting 技能附的 headline_scorer.py 會從力量詞、情緒詞、數字、長度、具體度、清晰度六個面向打分。
H=marketing-skill/skills/copywriting/scripts/headline_scorer.py
python3 $H 'Sherlock 工具介紹'
python3 $H '123'
python3 $H '亂打的帳號也說「找到」?實測 9 萬星找帳號神器'
| 標題 | 分數 |
|---|---|
| Sherlock 工具介紹 | 20(F) |
| 123 | 38(F) |
| 亂打的帳號也說「找到」?實測 9 萬星找帳號神器 | 48(D) |
| I Typed a Fake Username and It Still Said Found 8 Times | 50(D) |
只打三個數字的「123」比正常的中文標題高分。我們實際用過的中文標題被判定成「5 words — too short」,因為它用空格切字,一整串中文只算一個字。
結論:適合誰、不適合誰
這包的說明書數量大致誠實,附帶程式九成以上能啟動,品質比很多「大全」型專案好。但它是寫給英文行銷與軟體工程團隊的:評分類工具的規則全建立在英文上,拿中文內容去跑,分數沒有參考價值。
- 適合:用英文寫行銷內容、或在軟體團隊想找現成流程範本的人;挑幾個需要的技能複製進去就好。
- 不適合:想用它檢查中文文案、中文標題的人;也不建議整包 388 個全裝,大部分你用不到,只會讓 AI 多讀一堆說明。
專案連結:https://github.com/alirezarezvani/claude-skills(MIT 授權)