故意做壞小店網頁:免費檢查工具 claude-seo 抓得出幾個錯
重點摘要
- claude-seo 的 fetch_page.py 不讓直接檢查本機網址(127.0.0.1),還沒上線的草稿要先存成 HTML 檔,改用 parse_html.py 讀檔。
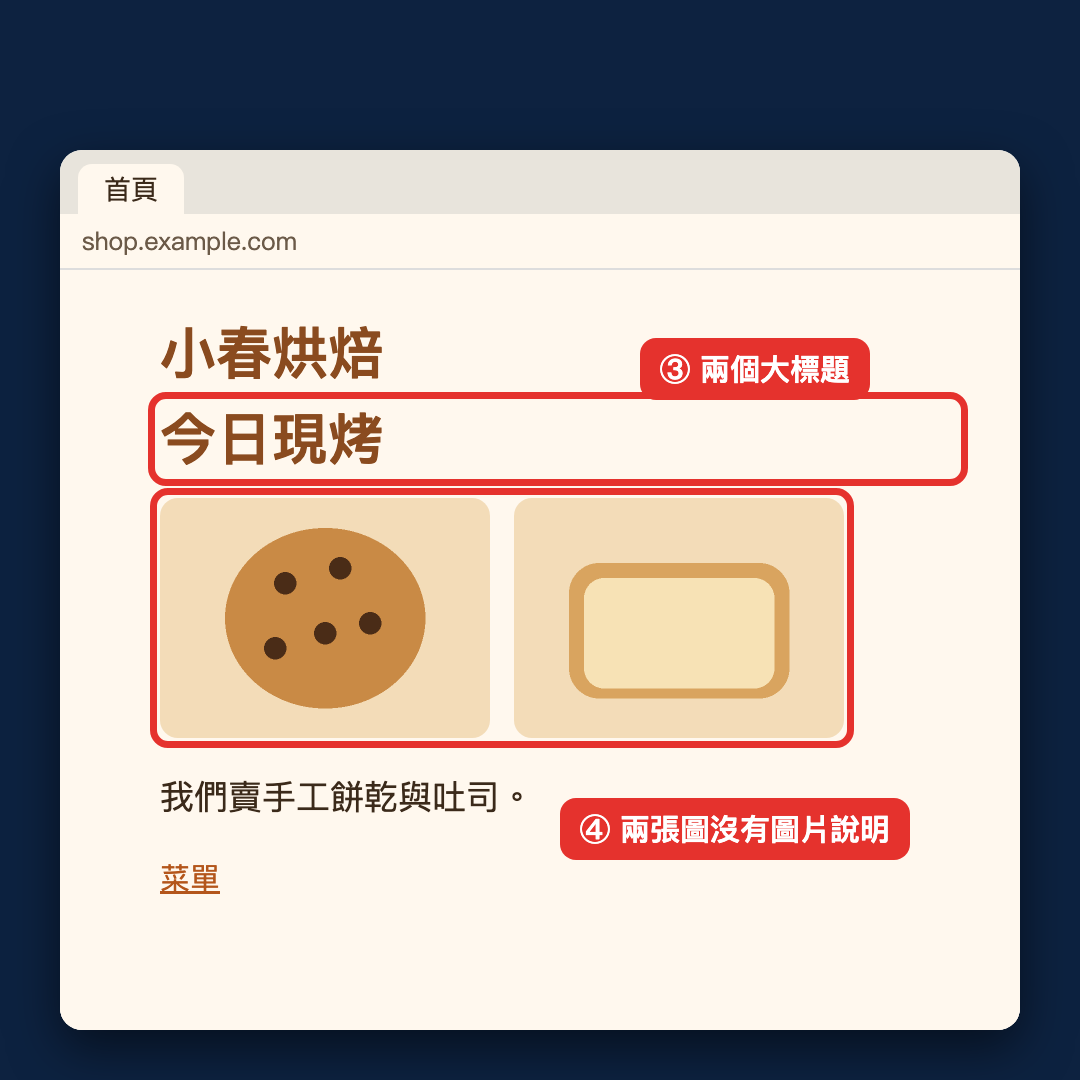
- 對自製、故意做壞的網頁,parse_html.py 列出標題只有「首頁」、沒有說明與 canonical、2 個 H1、2 張圖沒有 alt。
- content_quality.py 對只有兩三句的頁面給 70/100,同時旗標 low-density、thin-content(內容單薄)。
- schema_generate.py 的預約資料在實測中 reservationStatus 為 ReservationConfirmed,參數沒有狀態選項。
- 結論: 自己做小店網頁的人可以先用它的腳本掃基本毛病,但分數要連警告一起看。
- 適合: 自己做小店或個人網站、想先掃基本毛病的人
- 不適合: 想一鍵得到完整 SEO 報告的人
| 實測項目 | 結果 |
|---|---|
| 測試頁 | 自製故意做壞的店家首頁 |
| fetch_page 對 127.0.0.1 | Blocked hostname |
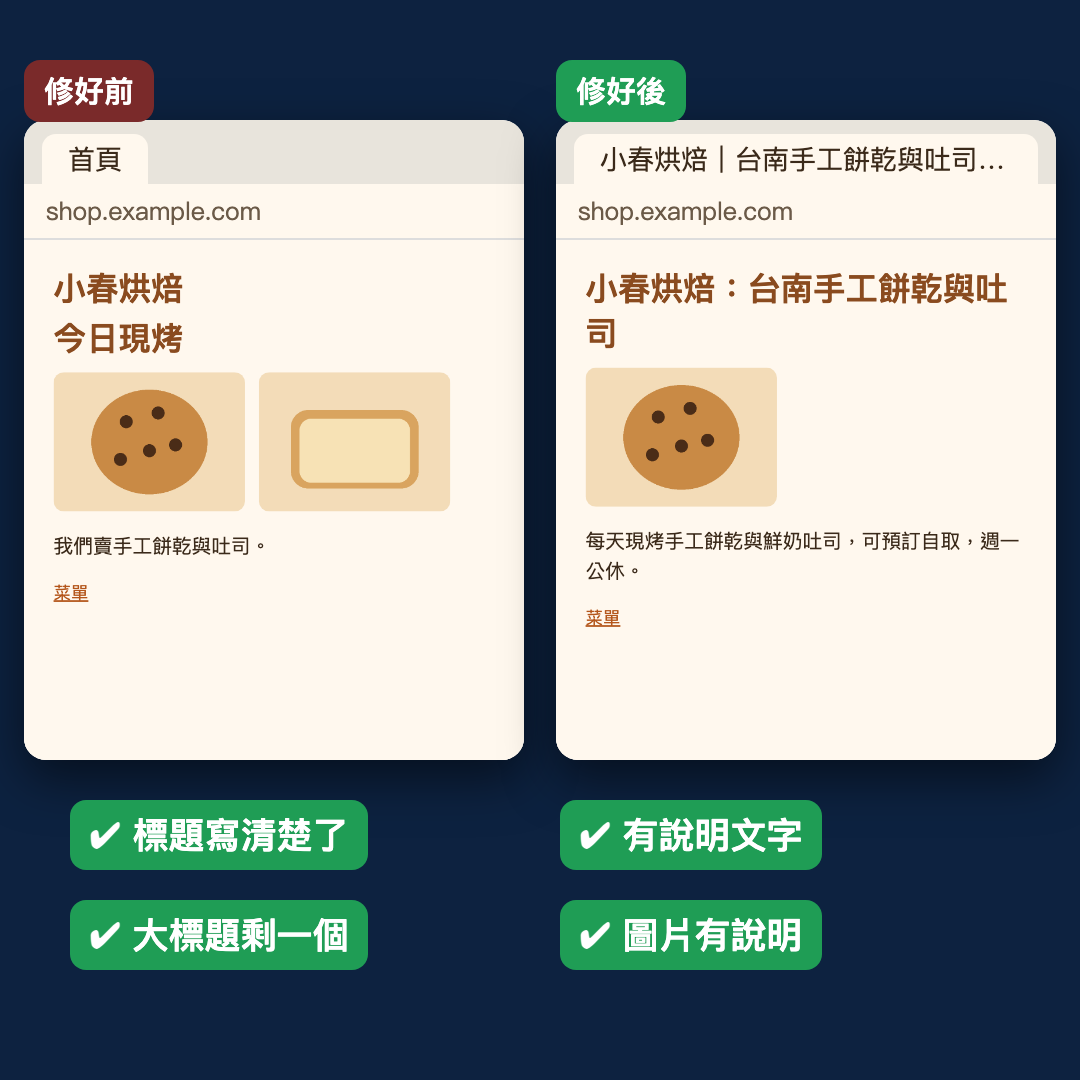
| H1 數量(壞→補完) | 2→1 |
| 圖片無 alt(壞→補完) | 2/2→0/1 |
| content_quality | 70/100,low-density、thin-content |
| 未測 | README 宣稱的完整審核流程、需金鑰的腳本、真實網站 |
你開了一間烘焙店,自己做了個網頁,Google 卻怎麼搜都搜不到,也不知道毛病出在哪。最近有個叫 claude-seo 的免費專案很熱,一週多了四千多顆星,說它能幫網頁找毛病。但它找得準不準?我的做法很像出考卷:先自己做一個「已知有錯」的網頁,再看工具能不能把錯找出來。如果連我故意放的錯都找不到,就不必信它。
測試設備:Mac mini M4 Pro(12 核、64GB)。專案:AgriciDaniel/claude-seo,MIT 授權。
它是什麼、我測了哪一塊
claude-seo 本身是 Claude Code 的外掛,README 說給它任何網站,10 到 15 分鐘就能跑完整審核。那個完整流程要在 Claude Code 裡用模型跑,我沒測。我測的是它 scripts/ 資料夾裡可以單獨執行的 Python 腳本:parse_html.py(讀網頁,列出標題、說明等基本欄位)、content_quality.py(替內容打分)、fetch_page.py(上網抓頁面)、schema_generate.py(產生給搜尋引擎看的結構化資料)。
出一張有錯的考卷
影片裡的網頁畫面,是依我當時實測記下的欄位值(標題、說明、大標題數、圖片說明數)重建的同款頁面,並另外用獨立程式核對過欄位與實測紀錄一致;工具的輸出與判斷都來自當時的實測,不是重跑。
<!doctype html><html><head><meta charset="utf-8"><title>首頁</title></head>
<body><h1>小春烘焙</h1><h1>今日現烤</h1>
<img src="a.jpg"><img src="b.jpg" alt="">
<p>我們賣手工餅乾與吐司。</p><a href="/menu.html">菜單</a></body></html>
我故意放的錯:標題只寫「首頁」(搜尋結果會只顯示這兩個字)、沒有說明文字、沒有 canonical(告訴 Google 哪個才是正式網址的標記)、有兩個 H1(頁面上的大標題,一頁通常只放一個)、兩張圖沒有 alt(圖片說明,看不到圖的人與搜尋引擎靠它理解圖)、內容只有兩三句。
實測一:還沒上線的網址不讓直接檢查
我先在自己電腦開了個 python3 -m http.server,想用 fetch_page.py 直接抓:
python scripts/fetch_page.py http://127.0.0.1:8000/
# Error: url_safety: Blocked hostname: 127.0.0.1
localhost 和 127.0.0.1 都被擋。這是它的網址安全檢查,用意是避免被拿去打內部網路。所以草稿頁要先存成 HTML 檔,再改用 parse_html.py 讀檔。
實測二:故意放的錯被逐項列出
python scripts/parse_html.py --json -u https://shop.example.com/ index.html
-u 是補上網站網址,不給的話站內連結不會被歸類。結果如下,每次執行都在 0.1 秒內完成:
| 項目 | 做壞的網頁 | 補完後 |
|---|---|---|
| 標題 | 首頁 | 小春烘焙|台南手工餅乾與吐司,每日現烤 |
| 說明文字(meta 描述) | 沒有 | 有 |
| canonical | 沒有 | https://shop.example.com/ |
| 大標題(H1)數量 | 2 | 1 |
| 圖片沒有說明(alt) | 2/2 | 0/1 |
補完的版本我另外存成 fixed.html 再跑一次,上表的欄位都到位。
實測三:70 分,卻說內容太少
python scripts/content_quality.py index.html
輸出是 Overall quality 70/100,同時旗標寫著 low-density, thin-content(資訊密度低、內容單薄)。這頁只有兩三句話。所以看這個工具要連警告一起看,分數好看不代表內容夠用。
實測四:預約資料的狀態
python scripts/schema_generate.py reservation --provider 小春烘焙 \
  --start 2026-11-05T15:00 --party-size 2
輸出裡 reservationStatus 直接是 https://schema.org/ReservationConfirmed(已確認)。我查了 --help,參數裡沒有狀態可以選。如果你的預約還在等店家確認,要自己改這個欄位。
常見問題
- 為什麼 fetch_page 不能抓我自己的電腦? 它擋掉本機與內部網路位址,草稿請存成檔案給 parse_html。
- 需要裝什麼? 我在乾淨的 Python 環境裝了 requests、beautifulsoup4、lxml 就能跑這幾支腳本;其他腳本(Google 搜尋、PageSpeed 等)可能要金鑰,我沒測。
結論
適合:自己做小店或個人網站、想先掃一遍標題、說明、標準網址、大標題、圖片說明這些基本毛病的人。 不適合:想一鍵得到完整報告的人(完整審核要在 Claude Code 跑,這篇沒測),也別把 content_quality 的分數當成內容夠好的證明。
專案連結:https://github.com/AgriciDaniel/claude-seo(MIT)